MiniMax a lancé MiniMax M3.1 Flash le 19 octobre 2026 avec un tarif de 0,15 dollar par million de tokens en entrée et 0,60 dollar par million en sortie. Le modèle est disponible via les services de l'entreprise, tandis que les poids seront publiés ultérieurement. La nouveauté concerne ceux qui construisent des agents et des logiciels: le prix unitaire baisse, mais le coût d'une tâche dépend aussi de la quantité de raisonnement du système, des outils qu'il utilise et des corrections nécessaires.
Le tarif divise par deux deux prix, pas chaque facture
La page officielle des prix permet une comparaison précise. Dans la tranche standard jusqu'à 512 000 tokens en entrée, MiniMax M3 coûte 0,30 dollar par million en entrée et 1,20 dollar en sortie. Flash divise les deux tarifs par deux. La lecture du cache passe de 0,06 à 0,015 dollar par million. Ce sont des postes de facturation différents: le prix du cache s'applique aux tokens effectivement reconnus comme réutilisables, pas à l'ensemble du contenu envoyé.
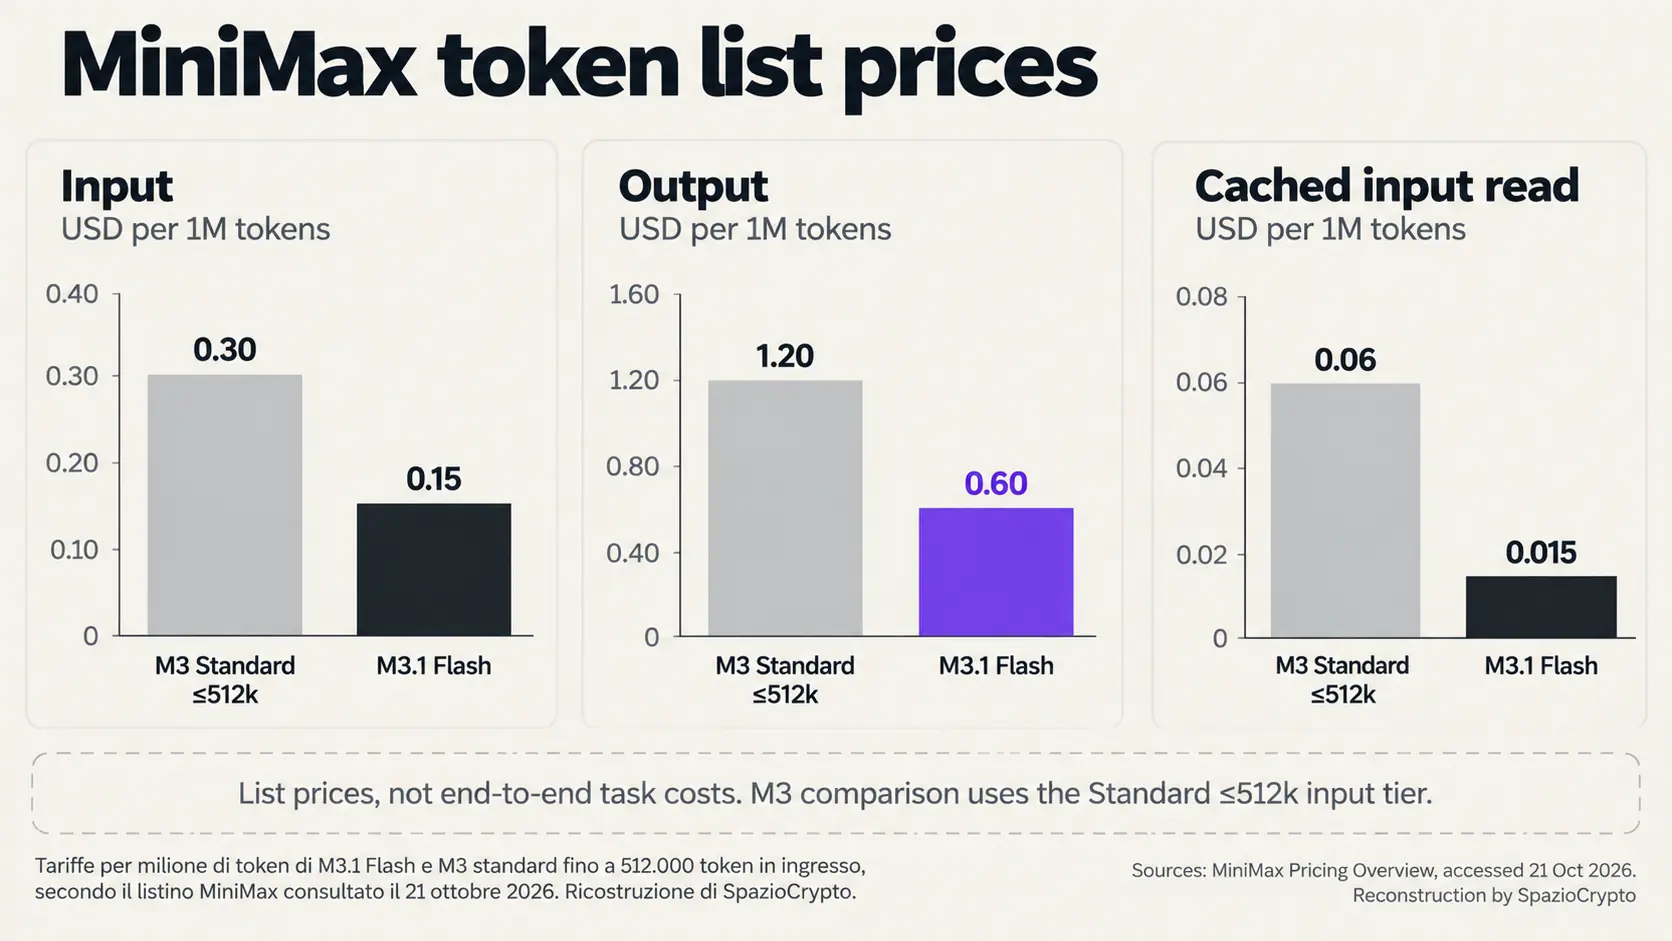
Le communiqué annonce un coût global des tâches agentiques inférieur de 70 % par rapport au prédécesseur. Ce chiffre ne correspond pas au simple doublement des deux tarifs principaux. Il peut inclure des différences dans la consommation et la manière de réaliser le travail, mais il n'autorise pas à promettre cette économie à chaque client. Pour ceux qui suivent l'adoption des systèmes automatisés, cette distinction sépare un tarif vérifiable d'un résultat opérationnel qu'il reste à mesurer sur sa propre charge.
Un exemple clarifie la différence. Un million de tokens en entrée, répartis entre des requêtes dans la tranche indiquée, et 100 000 en sortie, sans cache, coûteraient 0,21 dollar avec Flash et 0,42 avec M3. C'est un calcul indicatif, construit sur la même consommation hypothétique. Il ne comprend pas les appels supplémentaires, les outils ou le travail humain. Si un agent répète une étape ou produit davantage de raisonnement, la quantité facturée change même quand le prix unitaire reste identique.
Le raisonnement a un réglage, pas un arrêt
La documentation de l'interface compatible Anthropic décrit cinq niveaux de raisonnement, de low à max. Pour M3.1 Flash, max est la valeur par défaut lorsque le paramètre est omis. Le raisonnement adaptatif ne peut pas être désactivé avec les valeurs indiquées à cet effet: la documentation signale une erreur pour cette requête. Une intégration qui réutilise des configurations antérieures doit donc vérifier le comportement effectivement supporté par le nouveau modèle.
Selon ces mêmes instructions, augmenter le niveau peut produire davantage de tokens de raisonnement et une latence plus élevée. Le prix de chaque token et la durée totale de la réponse décrivent donc deux aspects distincts. Notre lecture est qu'un test utile doit maintenir constants l'objectif, les outils et les critères d'acceptation, en notant le niveau choisi. Autrement, on risque de comparer une réponse rapide à un travail plus approfondi sans expliciter la raison de la différence.
MiniMax M3.1 Flash: Space Performance + Bunny Speed 🚀🐰 Yes, Space Bunny - which has topped global leaderboards with 200T+ tokens - was an earlier version of M3.1 Flash. 💰Redefining the performance economics of agentic AI. M3.1 Flash achieves frontier-level intelligence across key tasks such as Cowork (Automation-Bench: 62%; ALE: 30%), Coding (DeepSWE: 74%) and Visual Reasoning (BabyVision: 91%), at 1/3 the cost of M3 and 3x the speed. API pricing (flat rate): $0.15 / $0.60 per 1M input/output tokens, with cache reads at $0.015 / 1M tokens. Model weights will arrive on Oct 23. API: https://t.co/fHRdSV73Hr M Plan: https://t.co/XfJWSyauda MiniMax Code for desktop: https://t.co/SGmLTI2HQm
, MiniMax (official) (@MiniMax_AI) October 19, 2026
Le catalogue officiel indique une fenêtre de contexte d'un million de tokens et des capacités multimodales. La capacité déclarée ne garantit pas que chaque long document sera traité correctement. Pour ceux qui intègrent le modèle via une interface API, l'enjeu est de conserver les informations nécessaires d'une étape à l'autre. Une requête très large peut contenir des instructions superflues ou contradictoires: pouvoir l'accepter ne démontre pas que le modèle sache toujours sélectionner le bon contenu.
Les benchmarks restent des tests circonscrits
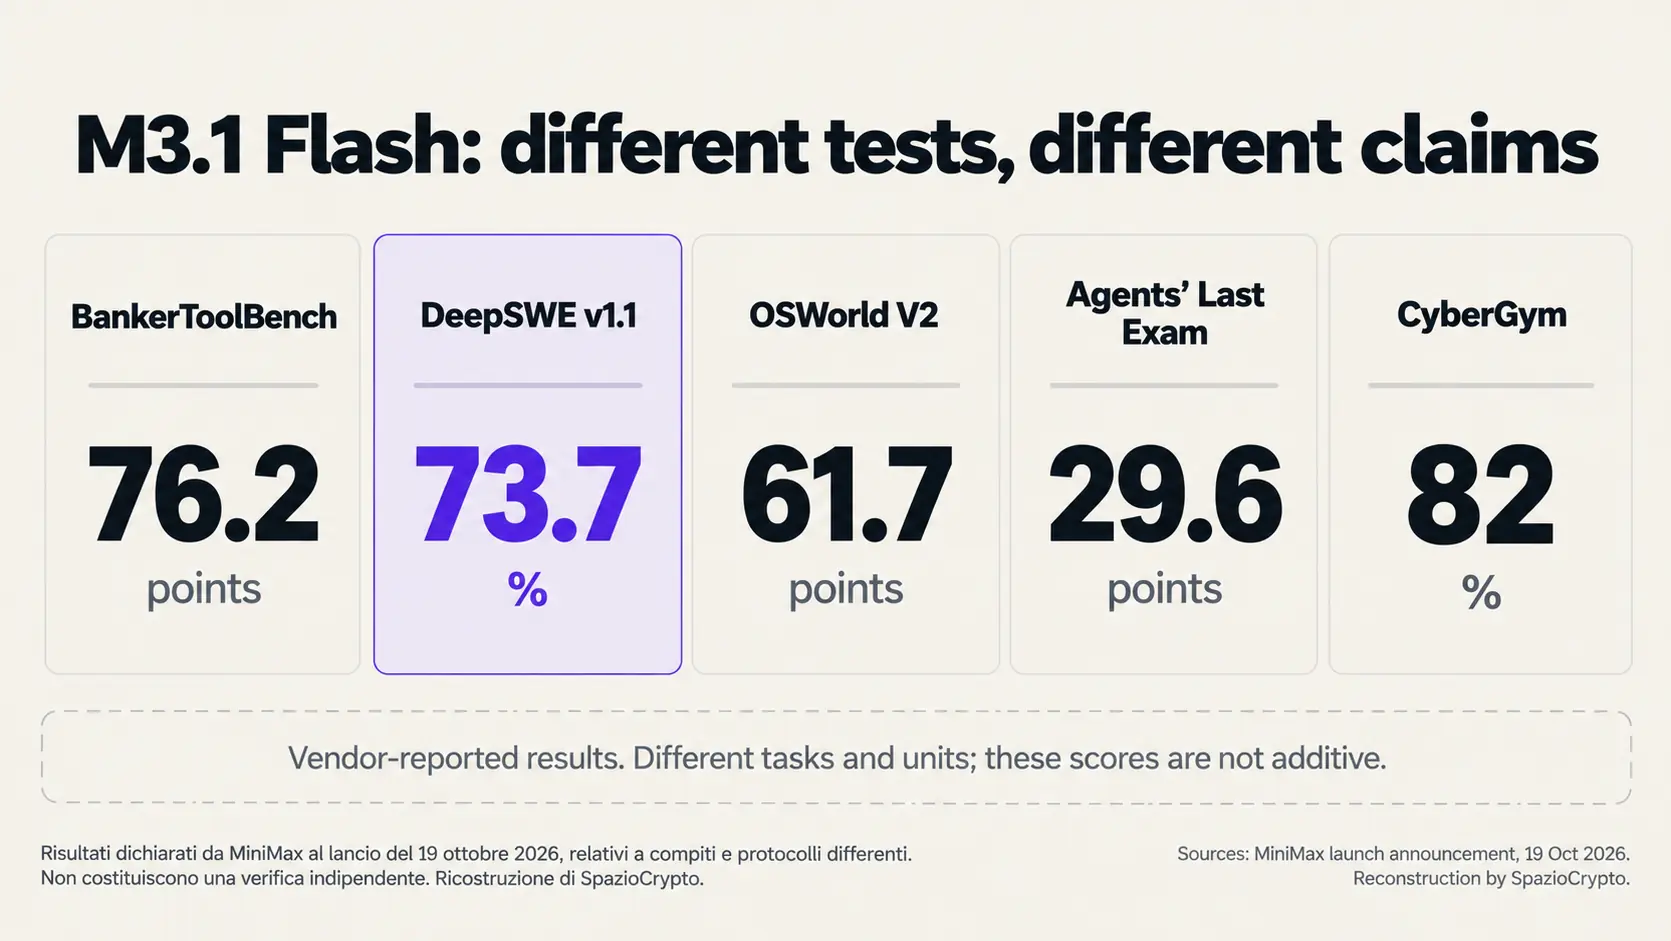
MiniMax publie des résultats sur la programmation, l'utilisation de l'ordinateur et la sécurité. Parmi ceux mentionnés dans le communiqué figurent 73,7 % sur DeepSWE v1.1, 61,7 points sur OSWorld V2 et 82 % sur CyberGym. Ce sont des résultats présentés par le fabricant. Le communiqué rapporte également 76,2 points sur BankerToolBench et 29,6 sur Agents' Last Exam. Ces tests observent des tâches différentes et ne peuvent pas être additionnés pour construire un pourcentage général de fiabilité. Un bon résultat sur des problèmes de code ne démontre pas, à lui seul, qu'un agent gère sans erreur des documents ou des autorisations financières.
Les vitesses requièrent elles aussi une étiquette. L'entreprise déclare plus de 200 tokens par seconde dans certaines conditions et une médiane supérieure à 170. Ce sont des données issues de sa propre infrastructure, pas une garantie sur le temps nécessaire pour compléter chaque procédure. Le nombre de tokens générés par seconde n'inclut pas automatiquement toutes les attentes entre un appel et l'autre, les réponses des services externes et l'intervention de la personne qui vérifie le résultat.
Cette distinction compte aussi dans les comparaisons entre benchmarks de modèles. Un chiffre doit être accompagné de la version du test, des outils autorisés et de la configuration de raisonnement. Notre lecture est que Flash nécessite des comparaisons avec un objectif identique et un budget déclaré. Présenter une capacité à trouver des vulnérabilités comme preuve de la fiabilité générale du modèle confondrait la tâche observée avec toutes les autres activités qu'il pourrait réaliser.
Artificial Analysis fournit une évaluation externe sur une autre suite: dans son post dédié, il attribue à Flash 42 points dans l'Intelligence Index, avec le raisonnement au maximum. Il rapporte environ 0,22 dollar par tâche de l'index contre environ 0,51 pour M3. C'est une évaluation publiée par un tiers différent du fabricant, non une réplication de notre part. Ce coût concerne les tâches et la méthode de son index: ce n'est pas le prix universel de n'importe quel travail confié au modèle.
Accès au service et contrôle des poids sont deux phases distinctes
Le lancement du 19 octobre indique trois canaux: l'API MiniMax, le M Plan et MiniMax Code. Le communiqué reporte les poids à un moment ultérieur sans date précise; un post de la page officielle MiniMax sur LinkedIn indique en revanche le 23 octobre. C'est une échéance annoncée, pas une publication déjà réalisée. Le service utilisable et l'artefact à télécharger restent donc deux phases distinctes. L'identification de Space Bunny comme version initiale du modèle est une déclaration de MiniMax; le nom anonyme ne constitue pas une évaluation indépendante.
MiniMax-M3.1-Flash scores 42 on the Artificial Analysis Intelligence Index, 13 points higher than MiniMax-M3 and less than half the cost per task. It scores level with GLM-5.3-Flash but behind DeepSeek V4.1 Flash 1017
, Artificial Analysis (@ArtificialAnlys) October 19, 2026
MiniMax-M3.1-Flash is @MiniMax_AI's new Flash reasoning… pic.twitter.com/bEelNegMKP
Notre lecture est que les deux modalités permettent des vérifications différentes. Un service hébergé permet de tester immédiatement l'interface et le comportement des réponses. La publication des poids ouvrirait la possibilité de conserver l'artefact et d'étudier d'autres configurations, selon la licence qui l'accompagnera. Le communiqué ne suffit pas à décrire cette licence ni le matériel nécessaire. Jusqu'à la publication, attribuer à Flash une disponibilité autonome déjà complète anticiperait une étape encore promise.
Le calcul utile est celui de la tâche accomplie
Dans le passage du coding assisté au coding agentique, le coût se distribue entre plusieurs tentatives. Un agent peut lire un dépôt, proposer une modification, exécuter des tests et revenir sur le code lorsqu'une vérification échoue. C'est un exemple opérationnel, pas un résultat mesuré sur Flash. La comparaison économique devrait comptabiliser l'ensemble de la séquence jusqu'à l'acceptation du travail, y compris les exécutions qui n'aboutissent pas à une solution utilisable.
La valeur d'une évaluation indépendante dépend aussi de la mesure dans laquelle ces séquences sont observables et reproductibles. Notre proposition est d'enregistrer le résultat, la consommation, les répétitions et les corrections, en maintenant identique le critère d'acceptation du résultat. Abaisser le niveau de raisonnement peut réduire une seule attente et augmenter les révisions ultérieures. C'est une hypothèse à vérifier sur la charge choisie, pas un comportement que nous attribuons au modèle sans l'avoir mesuré.
MiniMax M3.1 Flash
- Confirmé: lancement du 19 octobre, tarif public et documentation de l'accès hébergé.
- Pas encore vérifié: publication effective des poids annoncés sur LinkedIn pour le 23 octobre et économies sur chaque processus.
- À suivre: consommation à tâche égale, corrections requises et disponibilité des artefacts promis.
La lecture d'ensemble
Notre lecture est que la compétition dans le domaine de l'intelligence artificielle appliquée se déplace du prix de la réponse vers le coût du travail acceptable. Le tarif de Flash abaisse une composante mesurable; il n'élimine pas la nécessité de vérifier le résultat. Un modèle abordable devient utile lorsqu'il réduit aussi les étapes qui nécessitent des corrections, à résultat égal et dans des conditions d'exécution identiques.
Les prochains signaux concrets seront le respect de l'échéance annoncée pour les poids, des comparaisons reproductibles avec des configurations explicites et des mesures sur des tâches représentatives. Il faut aussi observer ce qui se passe lorsque le système échoue: s'il signale la limite, interrompt le travail ou continue à consommer. Ce sont des différences qu'un tarif par million de tokens ne peut pas raconter, mais qui déterminent le coût final d'un agent fiable.