Google DeepMind a présenté le 27 octobre Genie 4, un modèle qui génère des environnements explorables en temps réel avec sons, musique et dialogues produits simultanément aux images. L'utilisateur se déplace au clavier et à la souris, et peut modifier la scène pendant que la simulation tourne, en tapant en langage naturel. Seul un groupe restreint de testeurs sélectionnés y a accès aujourd'hui. Pour les abonnés Google AI Ultra via Project Genie et pour les partenaires API, l'accès est annoncé comme «prochainement disponible», sans date précise. Et DeepMind elle-même indique noir sur blanc que les objets, la cohérence et la physique peuvent encore céder.
Nous avons lu l'annonce de DeepMind, signée par Raia Hadsell, Diego Rivas et Hang Qi, ainsi que le billet de blog de Google et la page du modèle. Nous n'avons pas pu ouvrir directement le post sur X ni reproduire la démo YouTube: le texte du post a été vérifié via l'embed publié par AI Lately. Les caractéristiques de Genie 3 proviennent de la couverture de The Decoder datant d'août 2025.
This is Genie 4, our most realistic and interactive world model yet. 🌐
, Google DeepMind (@GoogleDeepMind) October 27, 2026
Explore dynamic environments in real time to see how the scene responds, sounds, and how the people in it move, react, and speak. pic.twitter.com/6mmSUm9BBO
Ce que fait Genie 4
Genie 4 est un modèle de monde: il ne produit pas une vidéo à regarder. Un environnement qui répond aux commandes image par image. On part d'un texte ou d'une image de référence utilisée comme première frame. On explore ensuite avec les commandes clavier pour le mouvement et la caméra. En cours de session, on peut changer la météo, déplacer le cadrage, ajouter des personnes ou des objets. Selon DeepMind, un modèle Gemini adapte chaque requête à la scène et fait progresser le monde même entre deux commandes.
Le modèle s'appuie sur la famille Gemini. Gemini Omni ancre les scènes à l'apparence et au comportement du monde réel, tandis que d'autres modèles Gemini gèrent le raisonnement qui maintient la cohérence de la simulation. C'est la même famille que Google pousse dans le travail en entreprise avec le Gemini agent pour les entreprises, lui aussi en avant-première réservée.
Le saut déclaré: l'audio
DeepMind présente Genie 4 comme le premier modèle de monde en temps réel capable de générer de l'audio de façon native. Chaque environnement possède ses propres sons d'ambiance et sa musique. Les personnages parlent, et le dialogue s'adapte aux commandes et aux événements.
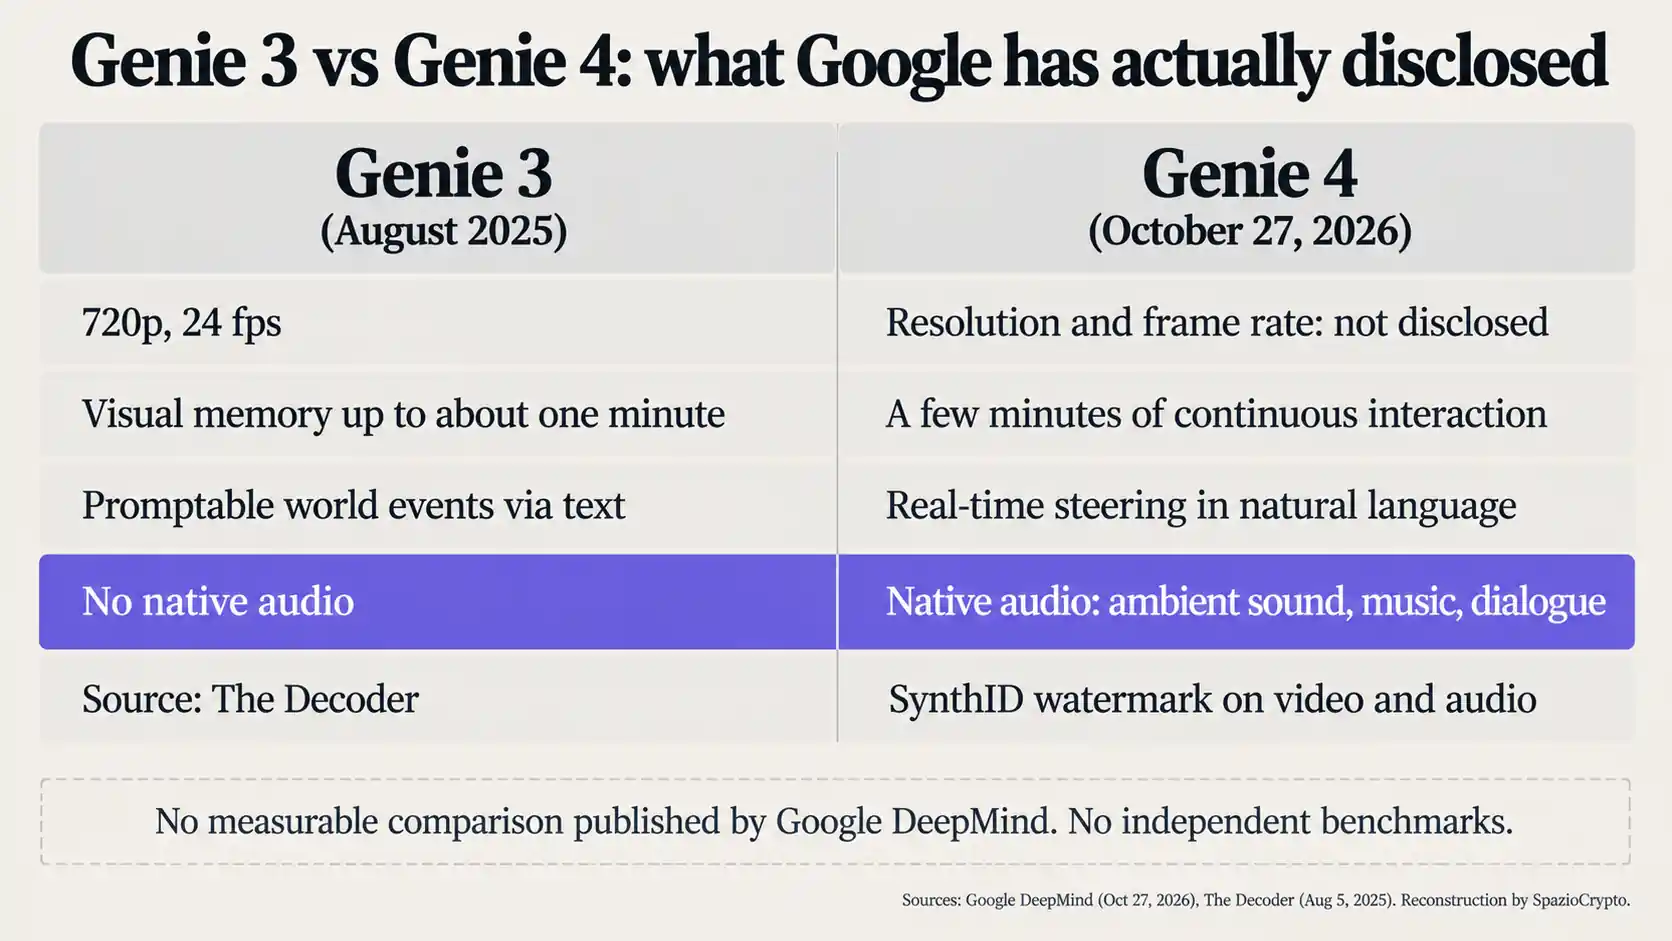
C'est là que réside la différence avec Genie 3, annoncé en août 2025. Selon The Decoder, ce modèle générait des mondes en 720p à 24 images par seconde, avec une mémoire visuelle allant jusqu'à une minute et des changements de scène via texte, appelés promptable world events. L'audio était absent. Pour Genie 4, DeepMind ne publie ni résolution ni nombre d'images par seconde, ni durée en minutes, et ne propose aucune comparaison mesurable avec la version précédente. La page du modèle évoque seulement «quelques minutes d'interaction continue».
Prototype interactif, pas une vidéo
La distinction compte pour comprendre l'usage réel. Un générateur vidéo produit un clip fermé. Genie 4 produit une scène qui réagit à celui qui la pilote. DeepMind liste des usages concrets: aperçus pour les réalisateurs qui peuvent tourner plusieurs prises dans une simulation en direct, photojournalistes qui tentent de transformer une seule photo d'archive en environnement, développeurs qui testent styles visuels et mécaniques de jeu à partir d'un texte, partenaires professionnels qui évaluent la génération rapide de scénarios. Ce sont des flux qui s'ajoutent aux outils déjà utilisés par les créateurs, comme ceux qu'Adobe et NVIDIA accélèrent.
Le terrain le plus stratégique reste la simulation pour agents et robots. Dans l'annonce, Gemini 3.8 Flash observe les frames, divise un objectif en étapes, vérifie chacune et corrige le plan quand le monde change ou quand l'utilisateur intervient. Dans une autre démo, Gemini 4 Argon travaille avec Genie 4 sur une tâche robotique impliquant le robot Apollo d'Apptronik et une partie de dames. Entraîner des agents dans des mondes générés est le même pari que celui de l'IA physique de NVIDIA et LG. Mais entre une démo et une ligne de production, la distance reste grande, comme le montrent bien les robots humanoïdes en usine.
Les limites, écrites par DeepMind
L'annonce ne cache pas les points faibles. Les détails visuels et la permanence des objets peuvent dériver, surtout lors des sessions longues, après plusieurs modifications via texte ou pendant la navigation. Restent en cours de recherche: les interactions physiques complexes, la précision de l'audio en temps réel, le texte lisible, la précision spatiale et la cohérence sur le long terme.
La page du modèle ajoute trois autres limites. La première concerne l'interaction entre plusieurs agents et plusieurs utilisateurs dans le même environnement. La deuxième porte sur les lieux réels, qui ne peuvent être reproduits avec précision. La troisième est la durée: quelques minutes, pas des sessions prolongées. Une note précise que les enregistrements montrés sont des sessions réelles mais raccourcies, avec des résultats à titre illustratif. Aucun benchmark ni évaluation indépendante: ce que l'on voit est une démonstration d'entreprise.
Qui peut l'essayer, et quand
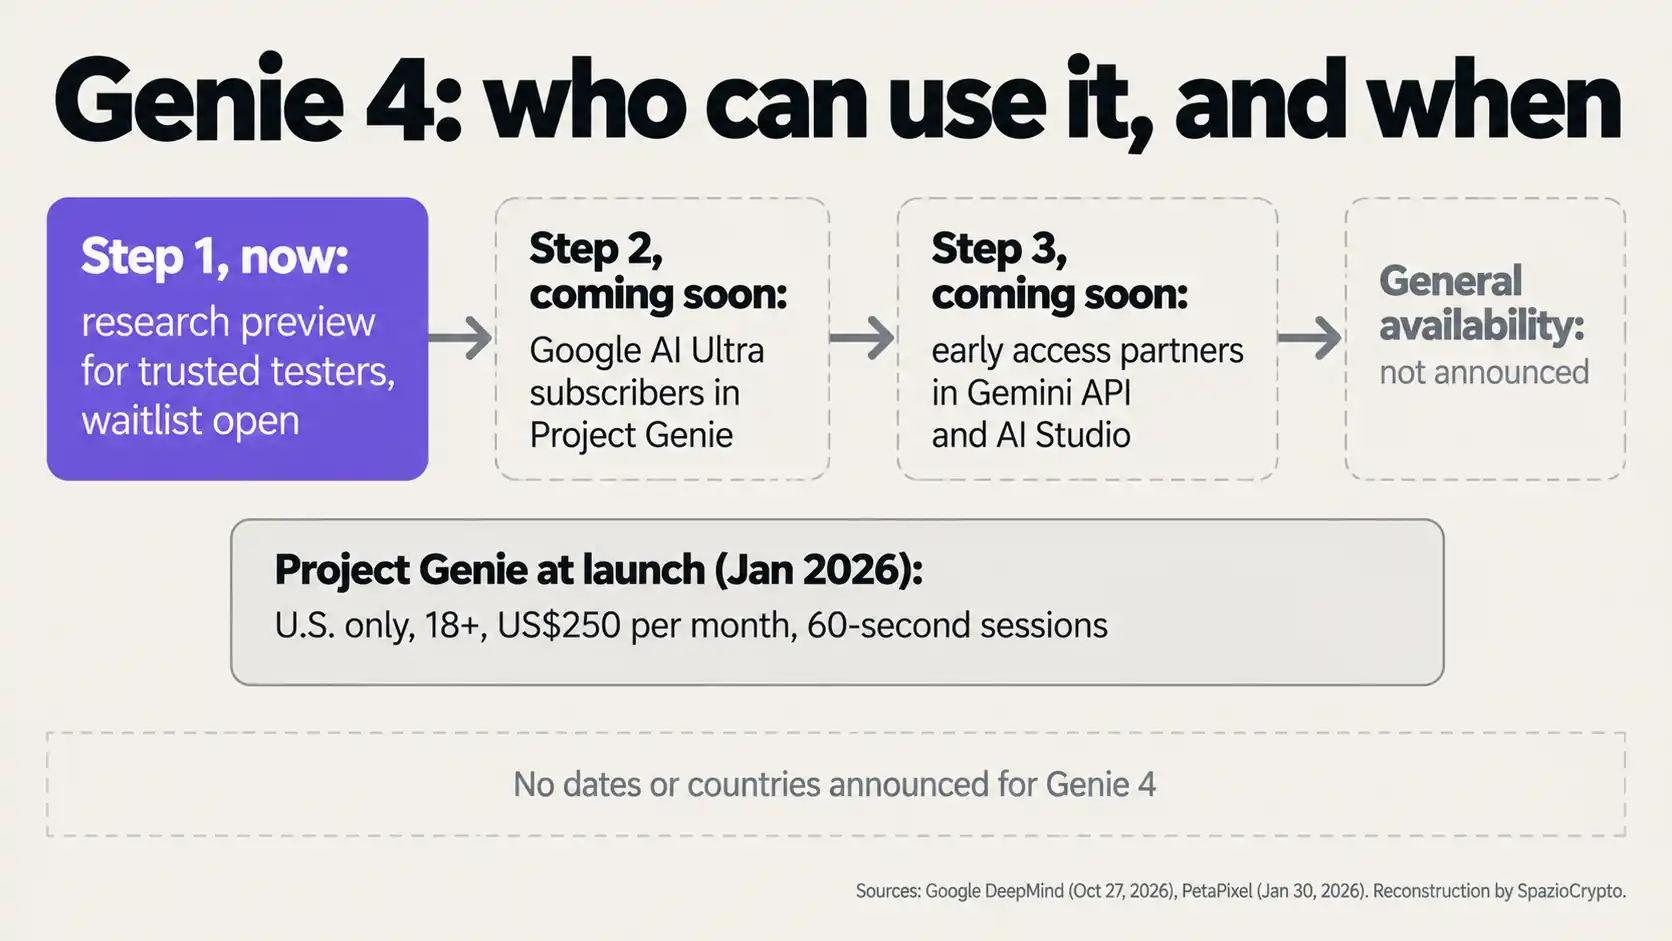
La réponse courte: presque personne, pour l'instant. Le modèle est en avant-première de recherche pour des testeurs de confiance, avec une liste d'attente ouverte. Viendront ensuite les abonnés Google AI Ultra dans Project Genie, puis les partenaires avec accès anticipé à l'API Gemini et à AI Studio. Aucune date, aucun pays mentionné.
L'historique aide à calibrer les attentes. Project Genie est né le 29 janvier 2026 avec Genie 3 et, selon PetaPixel, au lancement il était réservé aux abonnés Ultra aux États-Unis, majeurs, à 250 dollars par mois, avec des générations limitées à 60 secondes. On ignore si ce périmètre a été élargi depuis. Pour les utilisateurs francophones hors États-Unis, il n'existe aujourd'hui aucun parcours d'accès confirmé. Sur le plan de la transparence, DeepMind déclare que toutes les vidéos et tous les audios générés par Genie 4 porteront le filigrane SynthID: un sujet qui pèse, après des affaires comme la vidéo primée puis disqualifiée par Nikon pour usage de l'IA générative.
Genie 4
Ce qui est confirmé, ce qui ne l'est pas
- Confirmé: modèle de monde en temps réel avec audio natif, scènes modifiables via texte pendant la session, avant-première pour testeurs sélectionnés, filigrane SynthID sur vidéos et audios, limites déclarées sur les objets, la physique, l'audio et la durée.
- Non précisé: résolution, images par seconde, durée en minutes, pays et dates de disponibilité, tarifs API, benchmarks ou évaluations indépendantes.
- À surveiller: l'ouverture aux abonnés Ultra dans Project Genie et aux partenaires API, ainsi que les premiers tests indépendants sur la cohérence et la physique.
La lecture d'ensemble
Notre analyse, que nous assumons pleinement, est que Genie 4 déplace la course de l'IA générative du clip vers le monde. La vidéo se regarde; l'environnement s'utilise: on teste un niveau de jeu, on tourne une scène, on entraîne un agent. C'est pourquoi les limites déclarées pèsent davantage que dans un générateur vidéo classique. Un objet qui disparaît dans un clip est un défaut esthétique. Dans un simulateur pour robots ou agents, c'est une donnée fausse. La valeur réside dans le prototypage rapide, pas encore dans la simulation fiable.
Trois signaux méritent attention. Premier signal: quand et où l'accès s'élargira au-delà des testeurs, et avec quelle durée de session. Deuxième signal: si des évaluations indépendantes sur la permanence des objets, la cohérence et la physique finissent par arriver, aujourd'hui inexistantes. Troisième signal: dans quelle mesure l'usage avec des agents, comme ceux qui opèrent sur un ordinateur pour le compte des utilisateurs, passera des démos aux flux de travail réels.